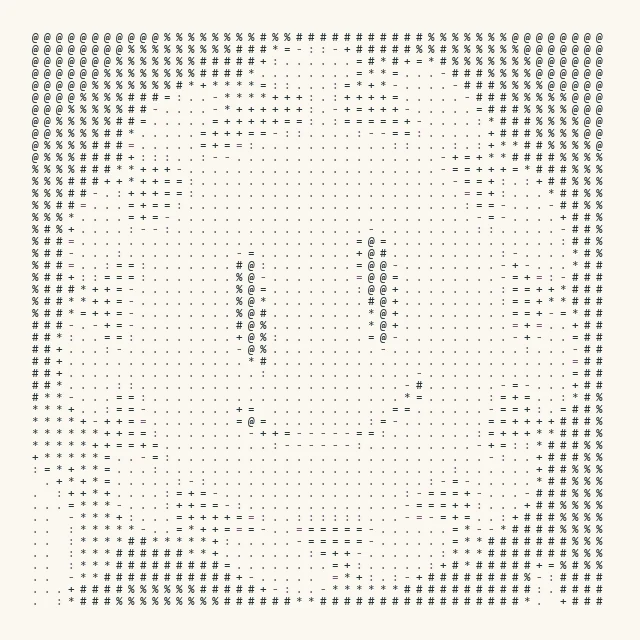
最近在研究字符画。常见算法会把原图切成固定大小的图像块,再按平均灰度为每块选择一个字符。
具体实现通常先建立灰度到字符的查找表,例如 [0~255] -> [0-9a-zA-Z!@#$%^&*()],再进行对齐或直方图均衡等处理。
以上实现具体可参考知乎:字符画——从入门到不屑
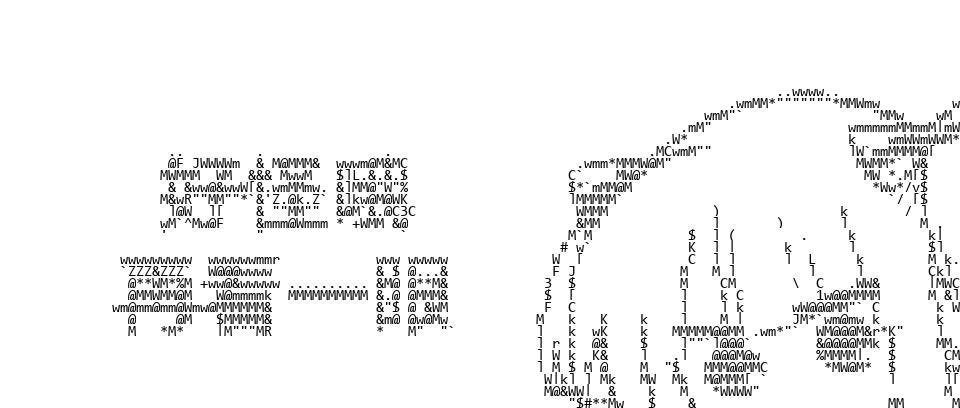
平均灰度匹配直观而简洁,但它没有比较字符的笔画位置。请见下图:
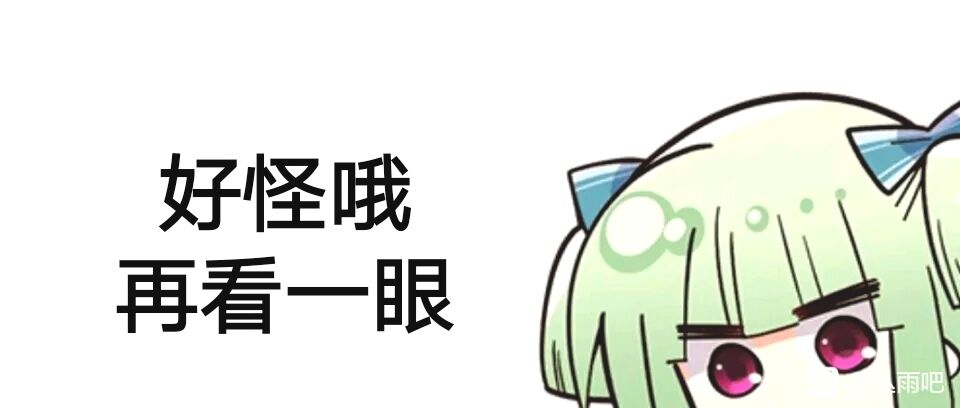
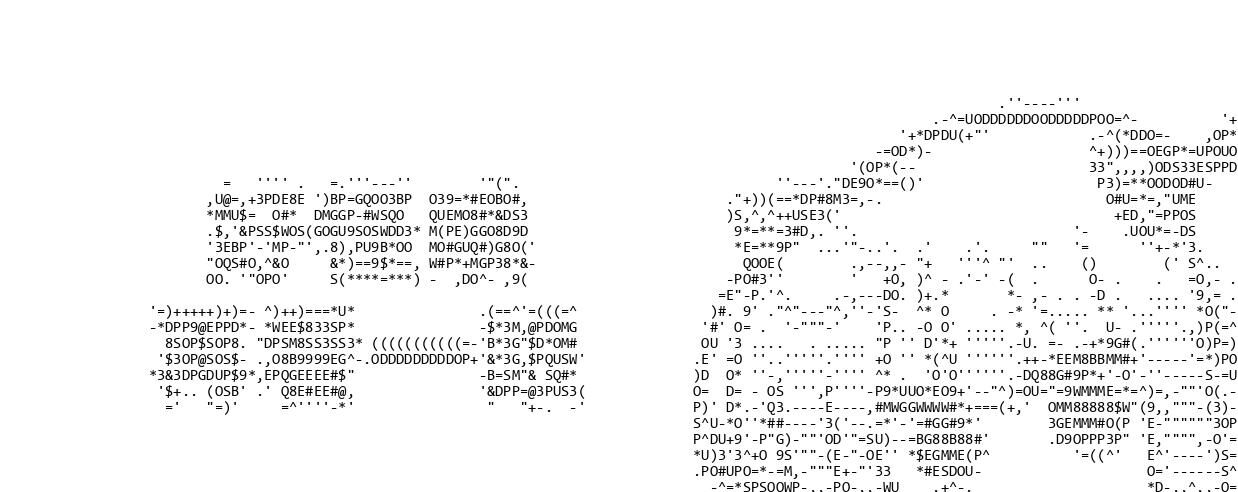
图中“好”字上沿出现了一行独立的单引号 ',“一”字上沿则变成纵向延伸、横线断裂的左括号 (。平均灰度接近的字符仍可能具有完全不同的笔画方向。
从图像处理角度看,这种方法先按字符尺寸降采样,再用平均灰度相近的字形替换每个图像块。字形与原轮廓不匹配时,会产生结构化误差。
本文改用字形模板直接比较图像块,使字符笔画尽量贴近原图轮廓。
字形匹配原理
字符画生成前需要固定候选字符、字体和字号,并把每个字符渲染为同尺寸的灰度字形模板。例如,一个由 3×3 个字符组成的“工”字图案,可以用字符 {1-+} 拼成:
-+-
 1
-+-
每个字符位置对应原图中的一个固定尺寸图像块。算法将该图像块与全部字形模板逐像素比较,再选择损失最小的字符。
设图像块为 $I$,候选字形模板为 $\hat I$,高度和宽度分别为 $h$、$w$。本文先使用均方误差(mean squared error,MSE):
\[J_{\mathrm{pixel}}=\frac{1}{hw}\sum_i\sum_j(I_{ij}-\hat I_{ij})^2.\]候选字符数量远小于图像块的可能取值。例如,8×16 的 8 位灰度图像块共有 $256^{8\times16}$ 种可能,100 个字符只提供 100 个字形模板。因此算法求得的是候选字符集中的最小损失,结果仍受字符集、字体、字号和块尺寸限制。
对所有图像块重复匹配,就能组成整幅字符画。
字形匹配实现
实现分为字形模板预生成和图像块匹配两步。
预生成字形模板
候选字符和字体固定后,字形模板可以预先渲染并保存,避免每次生成字符画时重复计算。
模板和原图都转换为 NumPy 数组进行批量计算,生成结果时再转换为 PIL.Image。
所有模板必须具有相同尺寸。即使选用等宽字体,实际渲染边界仍可能相差一个像素;这里把较大的模板裁剪到最小模板的宽高。更完整的实现还应统一基线和字形边界,避免裁剪掉有效笔画。
最后用 np.stack 将模板组成形状为 (num_chars, h, w) 的数组,便于批量计算损失。
匹配图像块
原图按模板宽高补齐并分块。每个图像块同时减去全部字形模板,计算损失后选择 argmin 对应的字符。
实现效果如下:
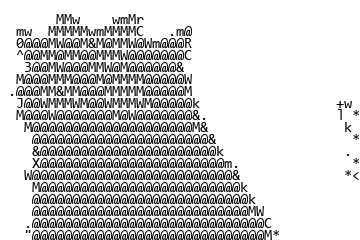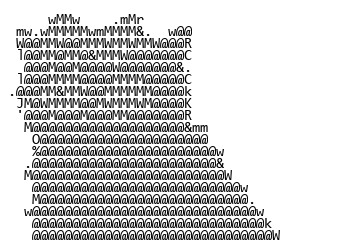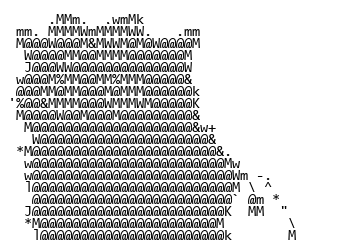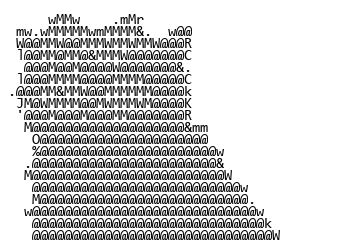
手部轮廓和猫毛方向比平均灰度结果更连贯,但黑猫面部的低对比细节仍然模糊。
额外改进
直方图均衡
候选字形提供的灰度层次有限。直方图均衡可以重新分布输入灰度,使部分低对比细节更容易进入可用范围。 改进效果如下:
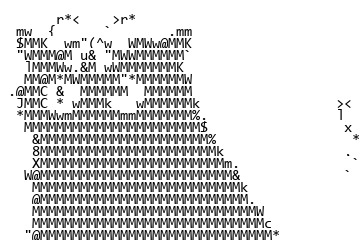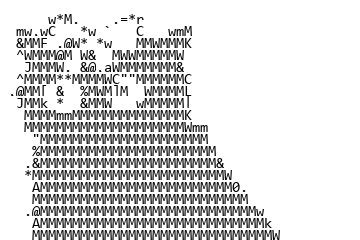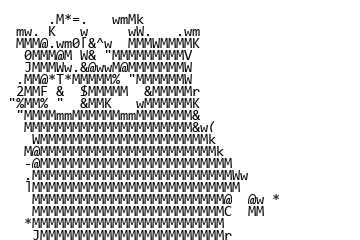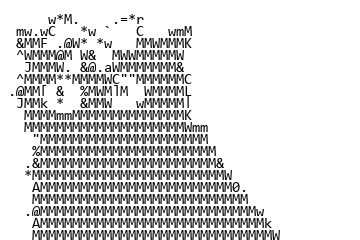
处理后黑猫的眼睛和蝴蝶结更亮,手部轮廓则有所减弱。
逐帧直方图均衡会带来两个问题:
- 各帧独立计算映射时,同一物体的灰度会跳变。可以从关键帧或整段动画估计一套全局映射;
- 均衡后的整体亮度可能偏离字形模板的有效灰度范围。可以改用目标直方图匹配,但本文尚未实现。
同时比较字形和平均灰度
像素 MSE 同时受笔画位置和灰度差影响,但在黑白字形模板与中间灰度图像块之间,笔画误差可能掩盖整块的平均灰度偏差。
因此加入平均灰度损失:
\[J_{\mathrm{gray}}=\left(\frac{1}{hw}\sum_i\sum_j(I_{ij}-\hat I_{ij})\right)^2.\]总损失是两项的加权和:
\[J=\lambda_{\mathrm{pixel}}J_{\mathrm{pixel}}+\lambda_{\mathrm{gray}}J_{\mathrm{gray}}.\]改进效果如下,原图:
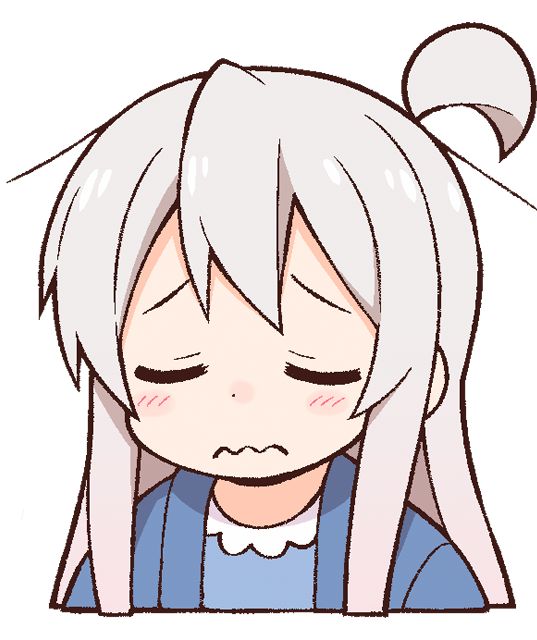
改进后:
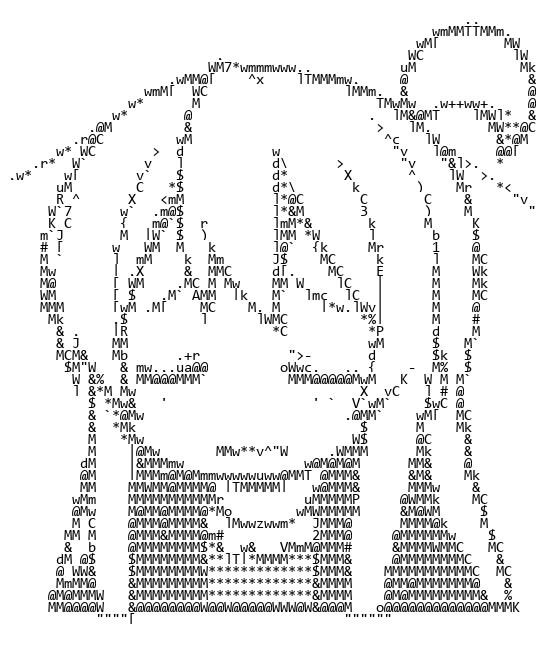
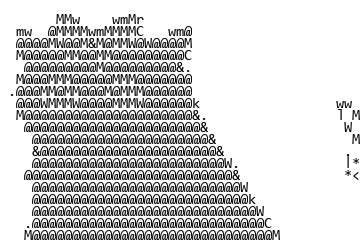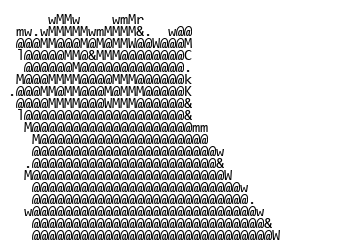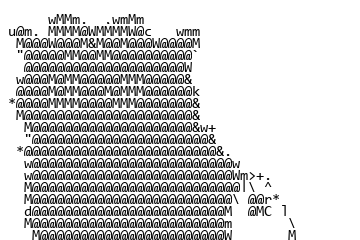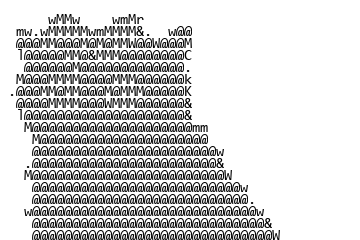
结果同时保留了较多轮廓和部分灰度色块。两个权重控制字形轮廓与平均灰度的相对影响。
组合损失前应检查两项的数值范围。若某一项大几个数量级,权重会难以解释,匹配结果也会长期偏向该项。初始权重的效果如下:
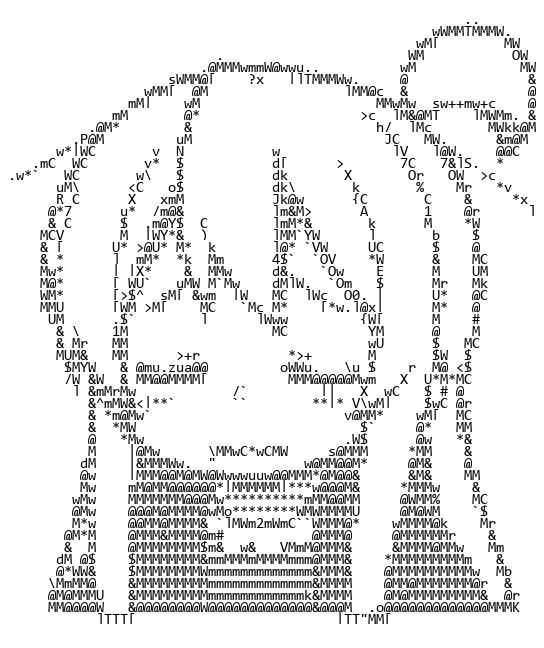
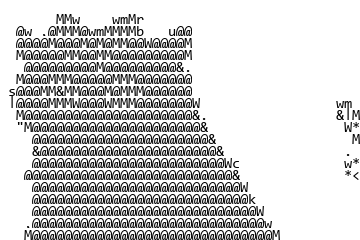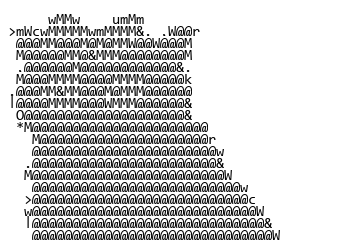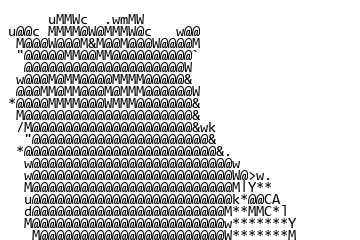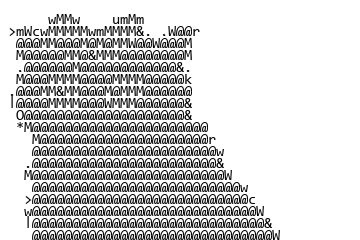
这组结果明显偏向平均灰度,说明初始权重没有平衡两项损失。后续可在代表性样本上统计两项分布,再设定归一化或权重。
NoneBot2 源码
我在 QQ 机器人框架 NoneBot2 中实现了上述方法。下面保留当时的 Python 代码;其中 grayscaleloss 对应 $J_{\mathrm{gray}}$,l2loss 对应 $J_{\mathrm{pixel}}$。
import numpy as np
from PIL import Image, ImageFilter, ImageDraw
from PIL.Image import Image as IMG
from PIL.ImageOps import equalize
from typing import List, Dict, Optional

from nonebot_plugin_imageutils.fonts import Font
from nonebot_plugin_imageutils import BuildImage, Text2Image

from .download import load_image
from .utils import UserInfo, save_gif, make_jpg_or_gif, translate
from .depends import *

charpic_char_map = r' `1234567890-=qwertyuiop[]\\asdfghjkl;\'zxcvbnm,./!@#$%^&\*\(\)_\+QWERTYUIOP{}\|ASDFGHJKL:"ZXCVBNM<>\?'
charpic_char_num = len(charpic_char_map)
charpic_char_font = Font.find("Consolas").load_font(15)
charpic_char_img = None  # (char_num, h, w)
def _init_charpic():
    global charpic_char_img
    def make(char) -> BuildImage:
        text = "\n".join([char])
        w, h = charpic_char_font.getsize_multiline(text)
        text_img = Image.new("RGB", (w, h), "white")
        draw = ImageDraw.Draw(text_img)
        draw.multiline_text((0, 0), text, font=charpic_char_font, fill="black")
        return BuildImage(text_img)
    charpic_char_img = list()
    for char in charpic_char_map:
        img = np.asarray(make(char).convert("L").image)
        charpic_char_img.append(img)
    char_h = min(img.shape[0] for img in charpic_char_img)
    char_w = min(img.shape[1] for img in charpic_char_img)
    for i in range(charpic_char_num):
        charpic_char_img[i] = charpic_char_img[i][:char_h, :char_w]
    charpic_char_img = np.stack(charpic_char_img, axis=0)  # (char_num, h, w)

def charpic(img: BuildImage = UserImg(), arg: str = Arg()):
    if charpic_char_img is None:
        _init_charpic()
    _, char_h, char_w = charpic_char_img.shape

    def make(img: BuildImage) -> BuildImage:
        img = img.convert("L").image
        if '平衡' in arg:
            img = equalize(img)
        img = np.asarray(img)
        img_h, img_w = img.shape
        img_h_ = img_h if img_h % char_h == 0 else ((img_h // char_h) + 1) * char_h
        img_w_ = img_w if img_w % char_w == 0 else ((img_w // char_w) + 1) * char_w
        img_ = np.ones((img_h_, img_w_), dtype=np.int32) * 255
        img_[:img_h, :img_w] = img

        p_h = 0
        while p_h < img_h_:
            img_h = np.repeat(np.expand_dims(img_[p_h:p_h + char_h], axis=0), charpic_char_num, axis=0)
            p_w = 0
            while p_w < img_w_:
                bias = img_h[:, :, p_w:p_w + char_w] - charpic_char_img
                grayscaleloss = np.square(bias.mean(2).mean(1))
                l2loss = np.square(bias).mean(2).mean(1)
                loss = grayscaleloss + l2loss
                img_[p_h:p_h + char_h, p_w:p_w + char_w] = charpic_char_img[loss.argmin()]

                p_w = p_w + char_w
            p_h = p_h + char_h
        img_ = Image.fromarray(img_)
        return BuildImage(img_)

    return make_jpg_or_gif(img, make)
评论
评论公开保存在 GitHub Discussions。只有在你手动显示评论或开启自动加载后,本页才会连接 giscus.app 与 GitHub,并发送当前页面路径。首次加载约 0.13 MB,实际用量随评论内容变化。请勿留下私人信息。